
本页内容
先看同一份 PDF 的公开解析结果
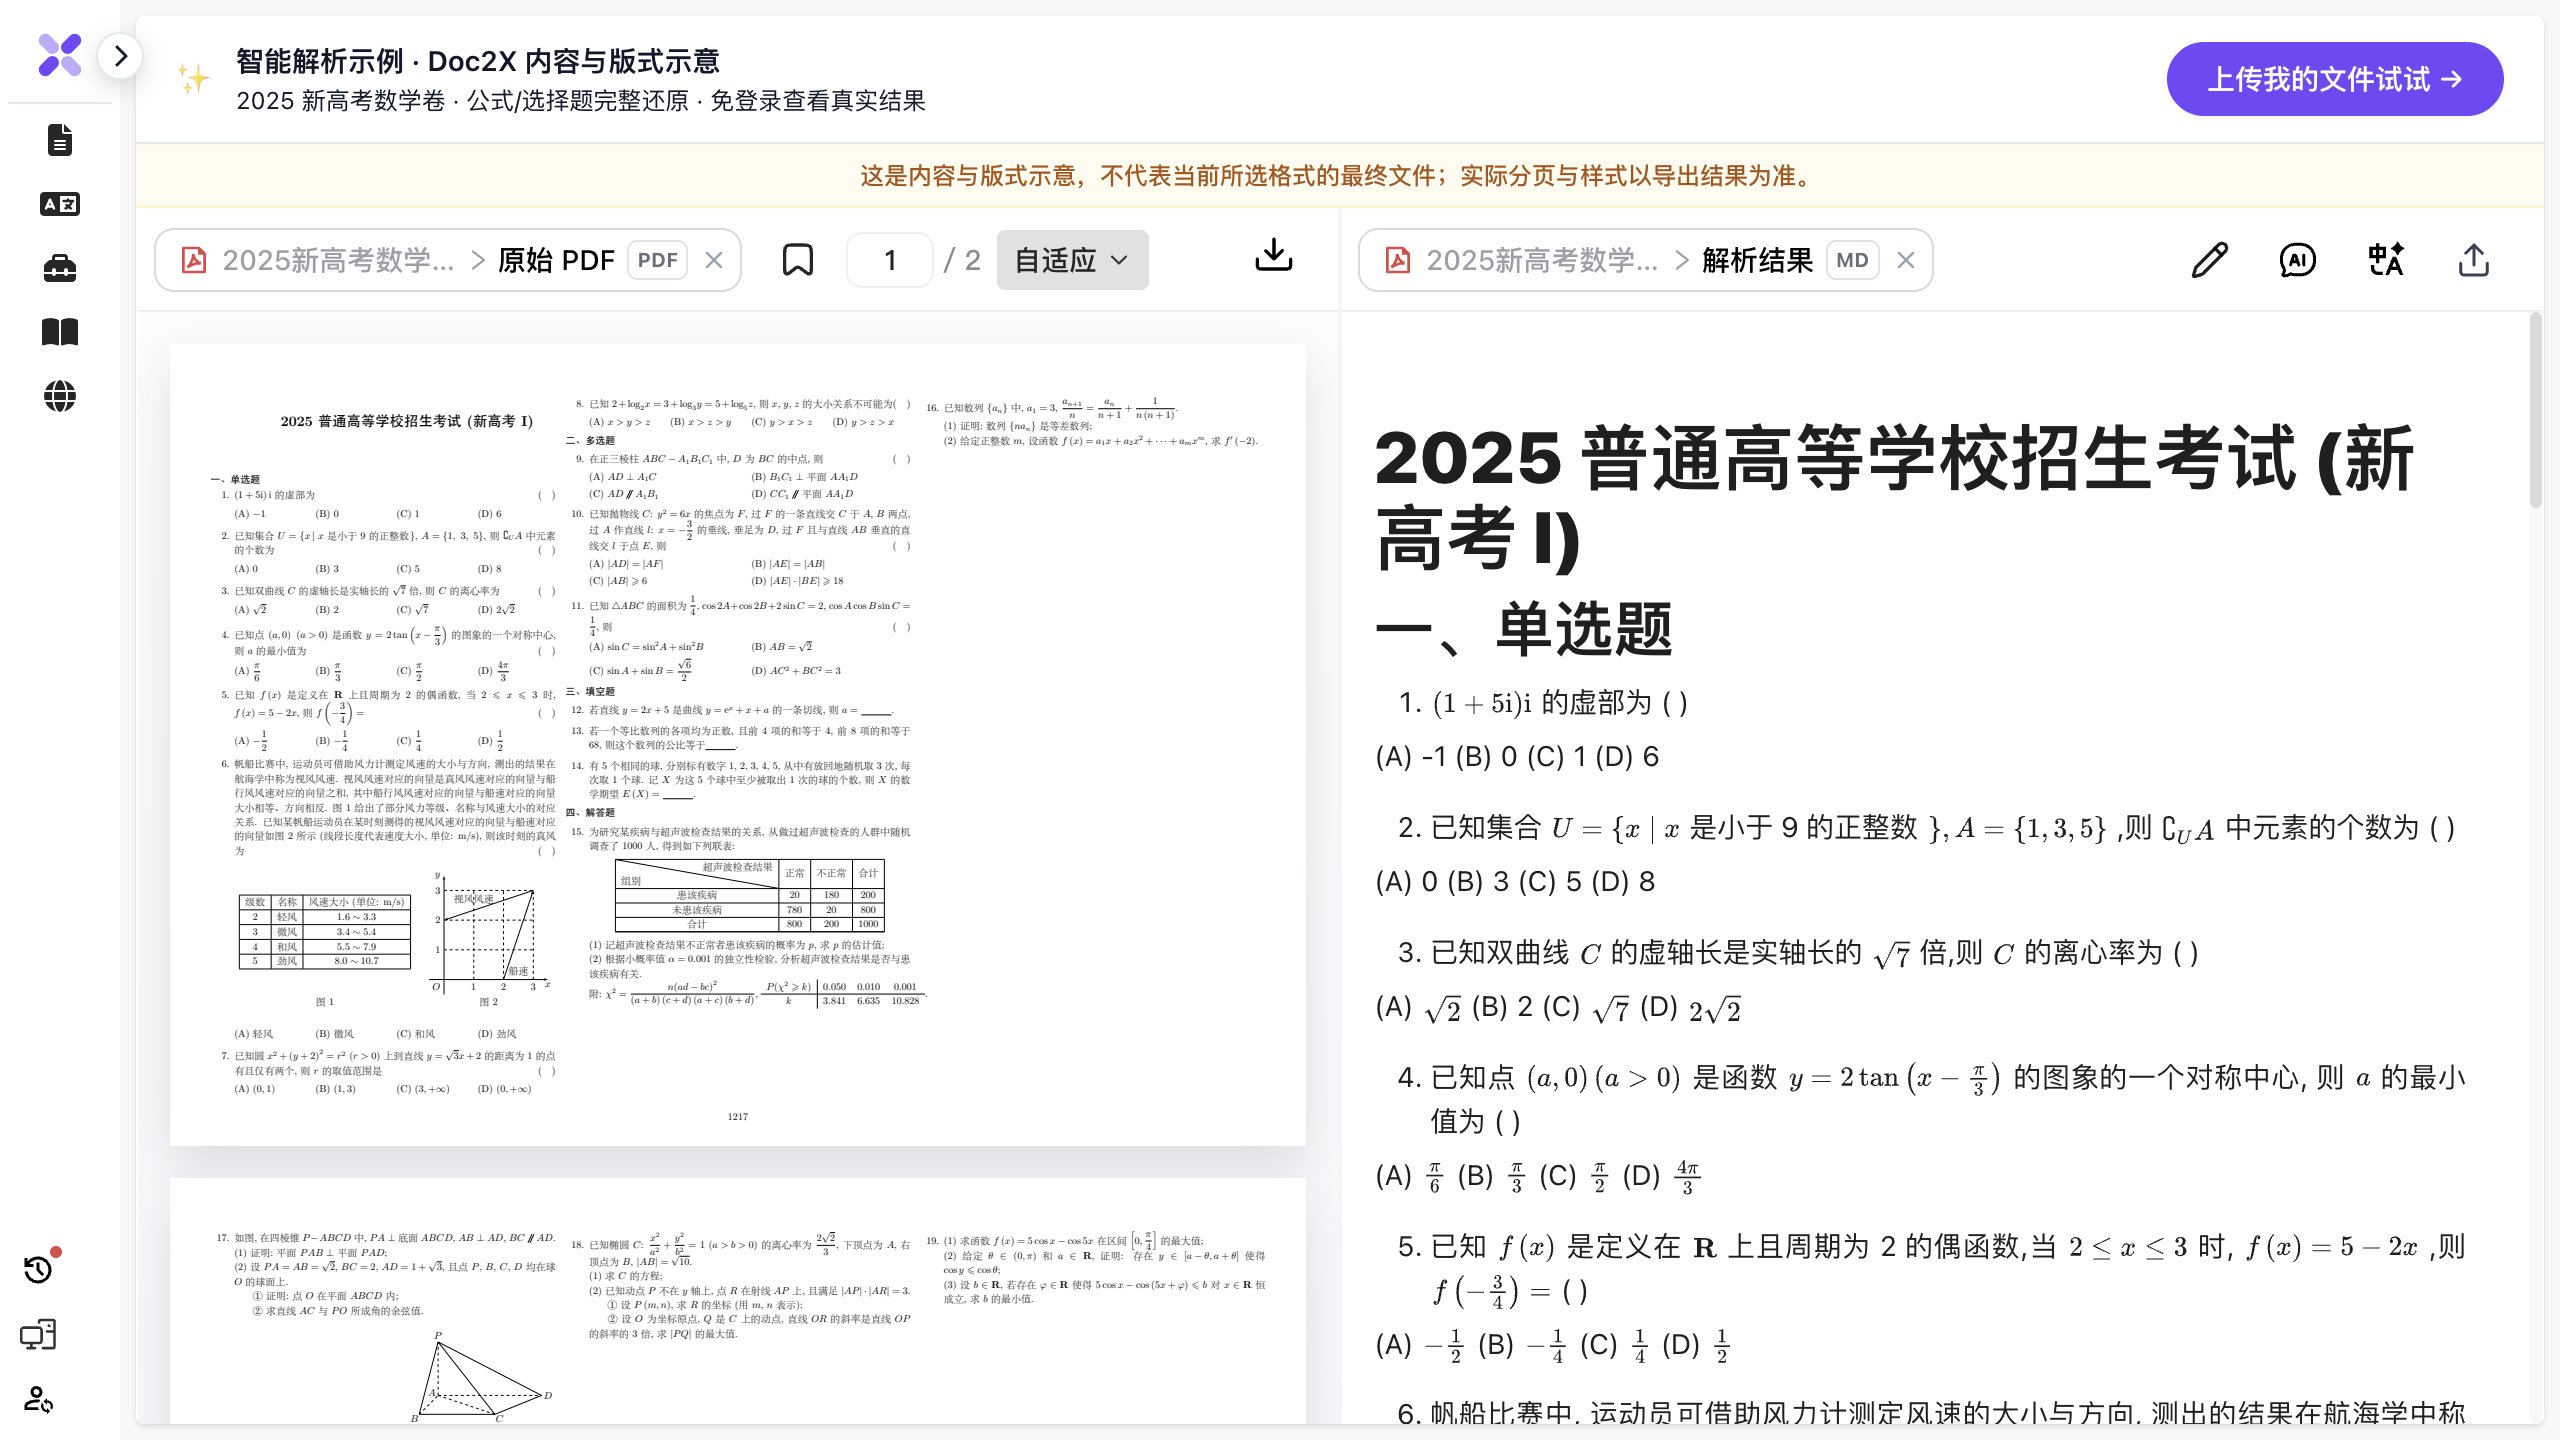
这份两页数学试卷包含三栏题目、公式、表格和配图。打开公开演示,可在左侧看原 PDF,在右侧核对解析正文;下方核对包原样保存同一 PDF 与网页演示 JSON,便于查看文字和页面的组织方式。
网页演示第 1 页的实际字段摘录(md 正文未展开)
{
  "url": "",
  "pageIdx": 0,
  "pageWidth": 2332,
  "pageHeight": 1649
}- 打开原 PDF 第 1 页,核对标题、题号、公式以及第 6 题风速表的单位和行列。
- JSON 的 pages 共两页,每页 md 保存正文。第 2 页含配图引用,保存 JSON 本身不会一并下载图片。
- 这个公开 JSON 使用 pageIdx 等网页字段,没有 layout.blocks。接入 API 时按下方官方字段说明读取实际响应。
2026-10-10 核对的既有公开样例,没有重新调用解析 API。ZIP 是原 PDF、网页 JSON、来源与校验记录的汇集,不是原始 API 响应或离线 Markdown 导出包,不含配图资源。网页演示数据和补建段落坐标不能用于验证 v3 API 坐标或识别准确率。
先了解这几件事
选择文档解析 API,先用自己的代表性 PDF 核对正文、公式、表格、图片和阅读顺序,再检查能否保存来源页码及需要的布局字段。Doc2X 开放平台提供 PDF/图片解析接入;PDF预上传显式选 v3-2026 后,通过原任务查询保存 data.result。Markdown、JSON结构检查、OCR准确性与后续RAG检索要分别验收,不能只凭HTTP成功或一个分数判断。
- 按资料选样本
- 原生PDF、扫描件、双栏、密集公式和复杂表格,应覆盖自己的实际输入。
- 按输出选字段
- 正文看Markdown,定位与元素关系看实际layout.blocks;下载文件与资源另核对。
- 先验收再扩批
- 上传、解析、导出是不同阶段;保存uid与原件,超时续查原任务。
- 离线检查边界
- 脚本验证成功状态与结果结构,不联网、不读取Key、不保证OCR或RAG答案正确。
先下载检查包:API 文档片段通过,网页 JSON 提示不匹配
同一脚本检查两种已公开数据:官方v3文档里的截断示例包含1页、4个块,离线结构检查通过;原有两页网页演示使用pageIdx,被明确提示不是PDF API字段。没有新调用API,也没有把两种来源拼成一份真实响应。
 查看原图 ↗
| 本例输入 | 脚本实际结果 | 能证明的范围 |
|---|---|---|
| 官方文档的截断JSON | 退出码0,1页、4块,无结构错误 | 样例结构能按文档读取;不验证全文或OCR准确率 |
| 既有网页演示原JSON | 退出码2,2页,pageIdx与API字段不符 | 识别数据来源差异;不会自动补造layout或bbox |
| 自己的已保存结果 | 在本机运行,并查看errors与warnings | 只读结构检查;内容、坐标定位与资源需回原页核对 |
实际离线报告:公开 API 文档片段(非新 API 运行)
{
  "check": "saved_api_result_structure_only",
  "passed": true,
  "inputShape": "api_status_response",
  "pages": 1,
  "blocks": 4,
  "pagesWithLayout": 1,
  "emptyMarkdownPages": 0,
  "blockTypes": {
    "Text": 2,
    "Title": 1,
    "FootnoteGroup": 1
  },
  "errors": [],
  "warnings": [],
  "doesNotEvaluate": [
    "ocr_accuracy",
    "reading_order_accuracy",
    "rag_recall",
    "answer_correctness",
    "image_availability"
  ]
}- 脚本接受成功parse/status外壳或保存的data.result。处理中、失败、重复页索引、重复JSON键与不合理bbox会明确报告;不会把HTTP成功当成任务成功。
- 使用--expect-layout时,缺少layout.blocks是错误;一般模式只提示,避免把未要求布局的结果当成v3结构。空正文、空布局或超出页面范围的坐标仍需人工核对。
- 只读取指定的一个本地JSON,最大20MiB,不联网、不读取API Key、不创建任务、不下载图片、不修改文件。输出不包含正文、资源URL、块ID或原文件路径。
- 文档片段有跳号和截断父子关系,因此脚本兼容额外字段及新类型,不强行要求所有关系都在片段内;实际引用闭环仍需用完整结果检查。
这是本地数据结构检查和待填写验收清单,不是新的API演示、OmniDocBench分数、竞品排名或RAG召回率。网页试卷JSON和API文档片段不是同一份任务,不能拿1页4块说明试卷的真实API布局。图为流程示意,非产品截图。
解压后先运行离线检查,再检查自己的结果
Python 标准库,本机只读检查
python3 check-doc2x-api-result.py api-docs-excerpt.json --expect-layout
python3 check-doc2x-api-result.py web-demo-pages.json --expect-layout
python3 check-doc2x-api-result.py result.json --expect-layout
前两条分别预期退出码0与2;第三条仅在你已保存自己的成功结果后运行。脚本不调用服务;真正预上传和导出按官方文档并核对账户条件。
文档解析 API 怎么选:按要交付的结果验收
| 你的需求 | 先检查什么 | 别只看什么 |
|---|---|---|
| 把PDF正文送到知识库 | Markdown文字、公式、表格单位和阅读顺序,对照同版PDF | 只看是否返回了一长段文字 |
| 扫描件或图片OCR | 清晰度、边界、文字和表格识别;图片接口按自己的输入约定 | 文件后缀或界面预览清楚 |
| 定位原页、裁图或高亮 | 实际page_idx、页面尺寸、bbox和元素关系 | 用网页pageIdx或文本长度猜坐标 |
| 给RAG提供可回源切片 | 原件版本、页序、表头单位、图注与片段来源 | 把结构检查或质量分当成召回率 |
| 批量生成MD、TEX或DOCX | 先查解析成功,再创建一次导出并轮询结果,及时保存图片 | 重复POST或直接套用网页所有导出格式 |
| 评估用量与等待时间 | 代表性文件、当前账户条件、错误恢复和结果保存期限 | 第三方旧额度或单个样例耗时 |
先按实际PDF选样本,再讨论工具选择
别只测试最简单的一页。按你的资料加入扫描页、双栏正文、密集公式、复杂表头、图注或代码,逐项记录错误与可修正性。公开样例能帮助理解输出,但无法替代自己的验收,也不提供未实测的竞品准确率排序。
API Key、客户端 Token 与网页版账户
开放平台 API Key 用于接口鉴权。客户端或 Zotero 的登录 Token 不能替代它,个人会员也不能直接当作开放平台 API 额度。开始前在对应平台确认资源和当前能力。
批量解析:先管理任务,再扩大数量
为每份输入保存文件标识与 uid。HTTP 请求成功、上传成功、解析成功和导出成功是不同阶段;只有相应状态完成才进入下一步。遇到并发或额度限制,应等待现有任务并按响应调整,不能承诺固定吞吐量。
超时后续查原任务,避免重复提交
本地等待超时不等于远端取消。保留 uid 并查询原任务;失败时记录错误码与脱敏信息,检查文件和账户条件后再决定下一步,避免无界重试和重复消耗额度。
保存正文,也保存需要的资源
成功后保存 data.result、原文件与任务信息。导出的 Markdown 或 LaTeX 可能在 ZIP 中带有图片,需完整保存并核对相对路径;网页演示中的 /samples/img/ 地址不代表自己的导出目录。API 结果与图片有保留期限,请按当前文档及时下载。
检查JSON语法与长编号源码
需要阅读公开JSON文本时,可先在本地JSON工具整理缩进、定位语法错误,保留大整数与重复键。对应中文指南提供实际输入和下载,不把语法通过当成接口字段或数据准确性的验证。
结果结构通过之后,还要验收什么
对照同版原PDF核对page_idx与文件页序、bbox范围、阅读顺序、表格单位和公式上下文;再确认图片已保存。后续RAG另做片段、权限、检索和答案回源测试。质量分不是逐字准确率,结构通过也不说明模型回答有依据。
如何开始
- 在开放平台确认额度与 API Key,先用一份代表性 PDF。
- 按预上传指南创建任务,保存 uid;将 PDF 二进制 PUT 到返回的上传地址。
- 有界轮询解析状态;成功后保存 data.result,失败或超时时按原 uid 排查。
- 需要文件时再创建导出任务,等待导出成功并下载;核对正文、公式、表格与图片后再扩展批量处理。
按上面的步骤,继续处理你的资料。
查看开放平台与 API 条件相关官方说明
遇到这些情况
- 上传返回成功,却取不到完整结果
- 继续查解析状态;HTTP 成功与 data.status=success 分别判断,不重复创建任务。
- 接口返回 429、并发或额度错误
- 按当前账户条件减少并行量、等待现有任务或检查额度;保存失败记录。
- 下载结果只有文字,图片显示不出来
- 检查保存的是正文 JSON、单个 Markdown 还是完整导出包。把需要的图片一起保存并检查实际路径。
常见问题
Doc2X API 和网页版会员通用吗?
按开放平台的账户、额度与计费条件接入。个人会员、客户端登录和 API Key 是不同使用入口,不能用一个入口的权益推断另一个。
v3 JSON 要调用 /api/v3 吗?
不是。按当前 PDF 文档在 /api/v2/parse/preupload 选择 model=v3-2026,再查询同一解析链路的状态;不要自行改写接口路径。
这个核对包是本次调用 API 得到的吗?
不是。它保存既有公开试卷与网页演示 JSON,用来核对内容组织方式;真实接入需按 API 文档运行自己的任务。
网页可以导出 Excel,API 也能直接传 xlsx 吗?
不能由网页选项推断接口参数。当前 PDF 导出指南列出 md、tex、docx;其他能力请查看开放平台的对应接口。
一个请求超时后可以直接重新创建吗?
先用已保存的 uid 查询原任务。网络中断或本地超时不表示服务器没有接收,直接重建可能造成重复任务。
文档解析API和普通OCR接口怎么选?
先按交付结果判断。只要一张图上的文字时,核对图片OCR即可;需要公式、表格、阅读顺序和页面定位时,检查对应文档结构。最后用同一批代表性材料对照原稿,不只比较是否能返回文本。
PDF转Markdown API可以直接完成RAG吗?
Markdown是输入的一部分。仍需保留来源、图片与表格单位,再处理切片、索引、权限、检索和回答验证;解析API不自动完成你系统中的这些环节。
拿到JSON,为什么脚本说pageIdx不是API字段?
本例公开网页演示使用pageIdx,PDF API文档使用page_idx。先确认数据来自网页还是接口、保存的是外壳还是data.result;不要只改字段名就把它当成完整API布局。
结构检查通过,可以不核对原PDF吗?
不能。脚本只检查数据类型与部分一致性,无法判断文字、公式含义、坐标覆盖或阅读顺序正确,也不测试RAG召回和答案。
内容核对:2026-10-16 · 功能条件与配额以当前产品界面为准